This blog post is also available in English: VictoriaLogs vs Loki, Elasticsearch, OpenSearch, SigNoz and ClickStack on structured log ingestion
在 VictoriaMetrics 内部,我们会持续地对自己的产品进行性能测试。这能帮助我们保持竞争力,让每一个版本都变得更好。随着越来越多的团队开始使用 VictoriaLogs ,也有越来越多的人问我们:它适合哪些场景?切换过来能获得什么?因此,我们把基准测试作为一个公开 GitHub 仓库发布出来,任何人都可以运行它来复现我们的结果,我们也会继续以开源的方式维护它。
这不是一篇劝你在迁移到 VictoriaLogs 的广告。相反,如果你在采集结构化日志(无论来自 Kubernetes 还是其他地方),本文应该能帮你选择合适的工具,并了解适合你的权衡取舍。
对不同系统进行比较的基准测试总是充满争议,因为每个系统擅长的场景各不相同。本文只测试一个场景:写入结构化日志,即每一行都带有命名字段的日志,Kubernetes 上的许多服务都是这样输出日志的。每个系统都运行在一台相同规格的机器上。查询性能、集群模式和对象存储会在后续文章中介绍。
仅凭写入速度无法决定该选哪个系统,所以本文也会深入它们的内部实现:
- 为什么 Loki 写入速度最快,但一个简单的 Dashboard 查询却要花上几分钟?
- 为什么 SigNoz 和 ClickStack 落后于 VictoriaLogs ,尽管三者都以列式方式存储日志?
- 为什么 Elasticsearch 和 OpenSearch 需要那么多磁盘空间?
这些问题的答案能帮助你规划硬件和成本,避免在日志量增长时遇到意外。
测试与环境
我们测试了截至 2026 年 10 月 6 个系统的最新版本,配置尽量接近默认值:
- VictoriaLogs v1.53.0
- Loki 3.7.8
- Elasticsearch 9.5.5
- OpenSearch 3.9.0
- SigNoz v0.145.0
- ClickStack 2.39.1
我们调整了少量配置,例如 Loki 的写入限制,以便每个系统都能在单节点上达到其设计上限。VictoriaLogs 不需要任何调整,因为它的设计目标就是开箱即用地提供最佳性能(文档)。仓库中说明了每一项改动。
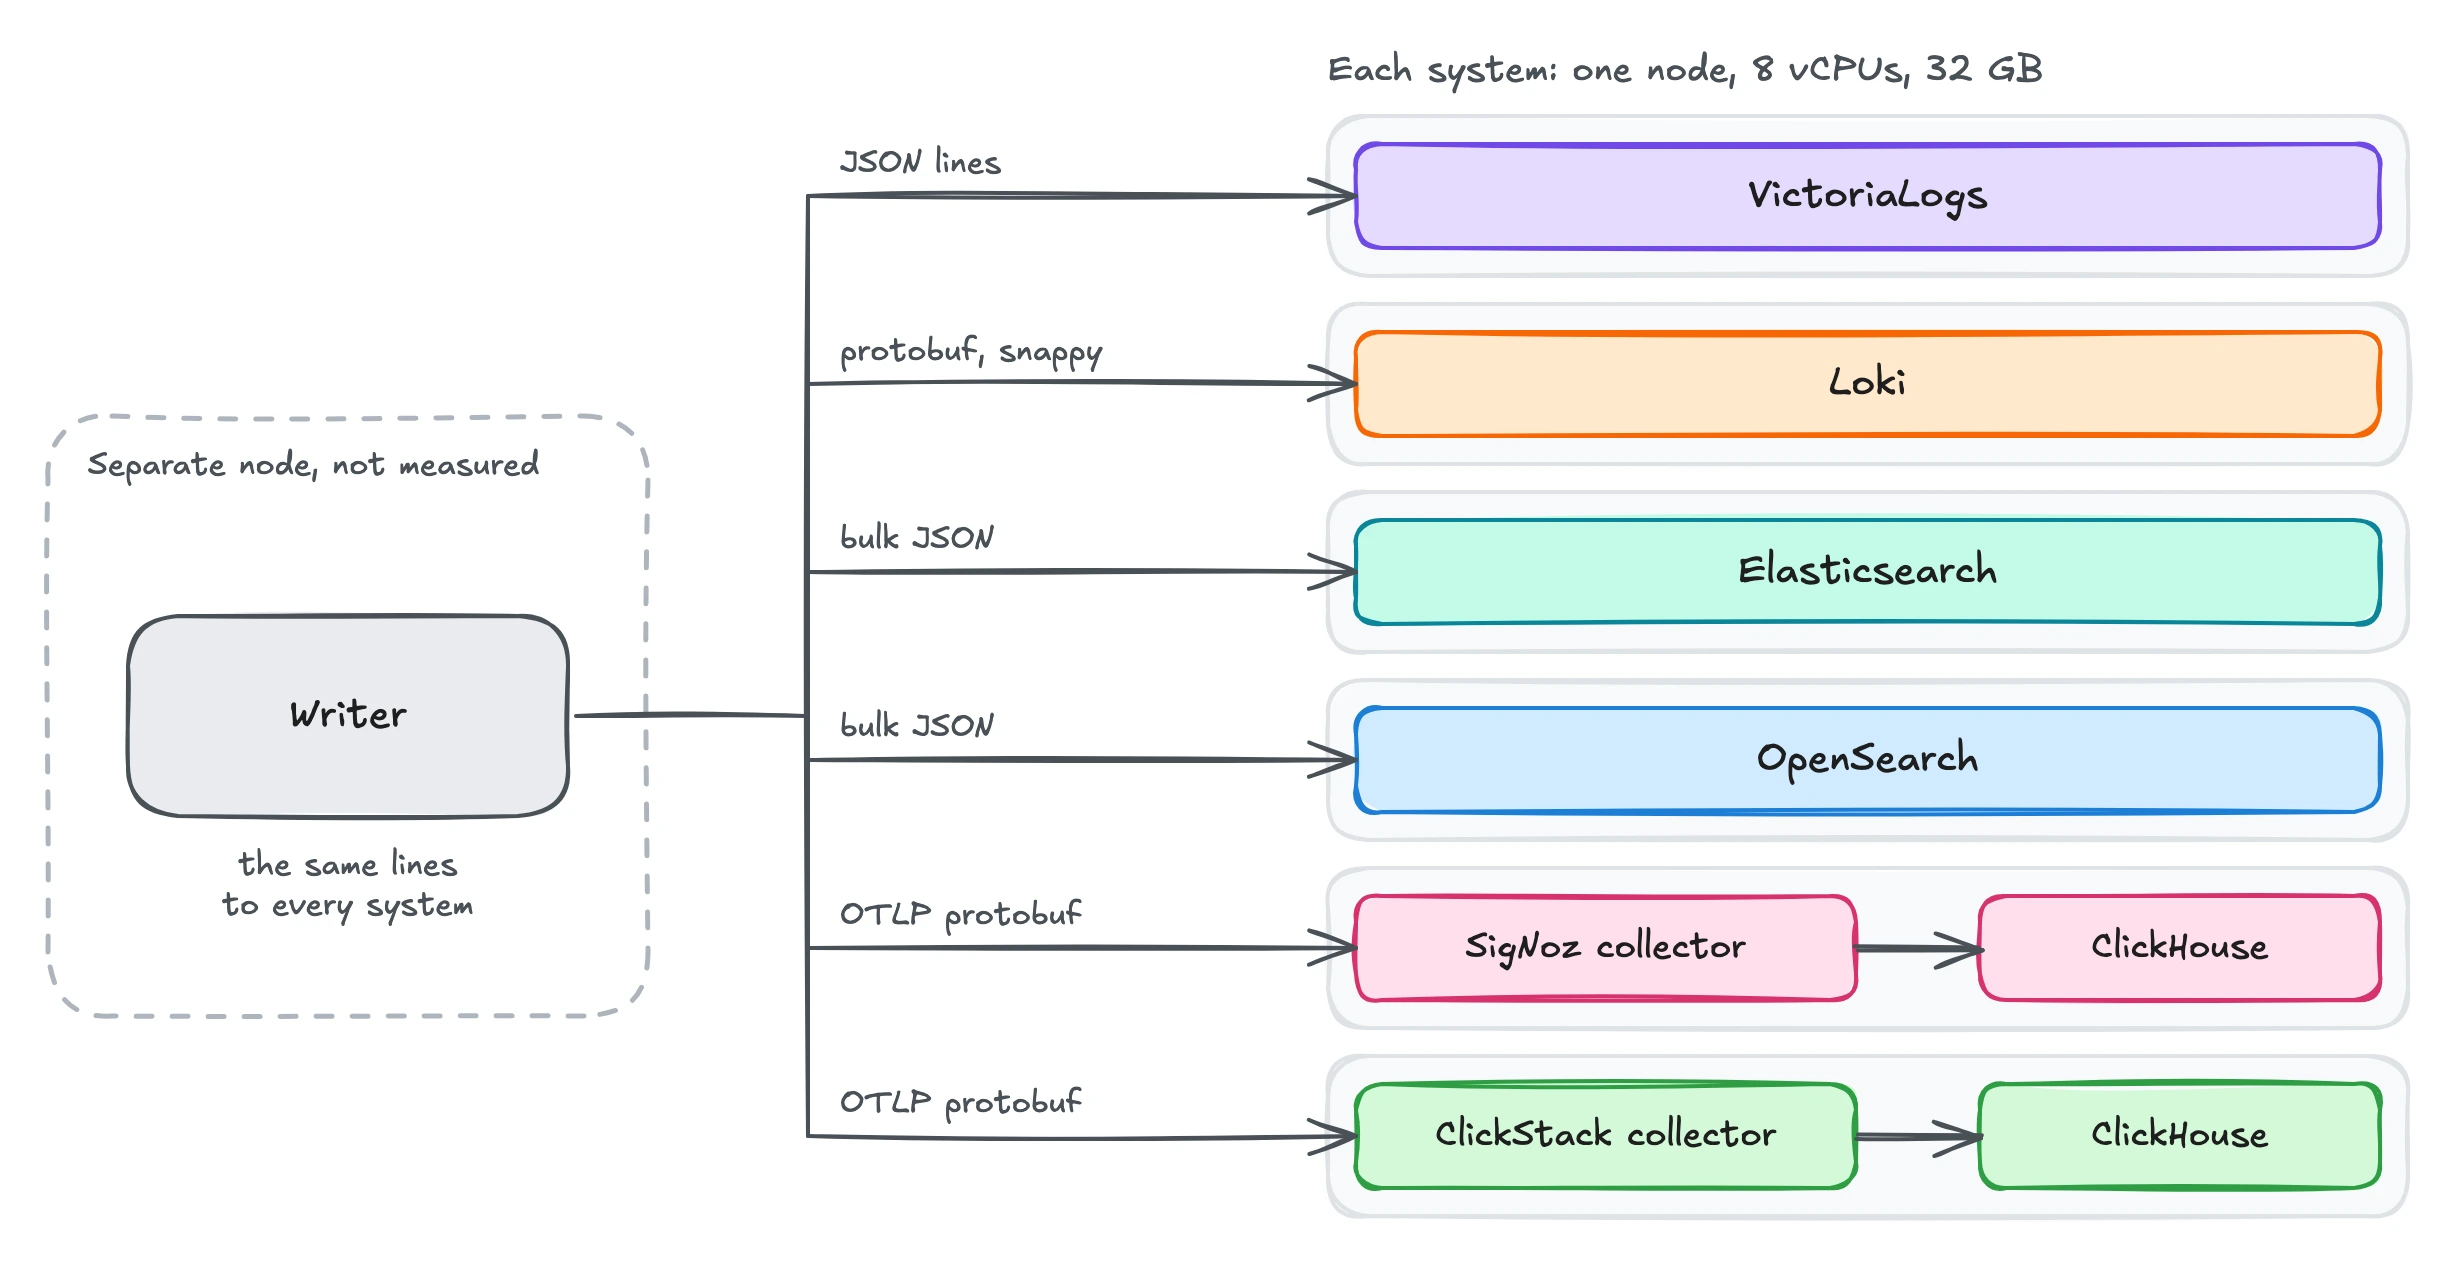
为了让测试保持简单,每个系统都以单节点模式运行在独立的 Kubernetes 节点上( GCP 的 n2d-standard-8 ,8 个 vCPU 、32 GB 内存)。SigNoz 和 ClickStack 将日志存储在 ClickHouse 中,而 ClickHouse 本身无法直接接收日志采集器发送的日志。因此每个技术栈都会在 ClickHouse 所在的节点上运行自己的 Collector ,这些 Collector 基于 OpenTelemetry Collector 构建。
我们同时向每个系统发送相同的日志。写入速率从 10k 行/秒开始,每 10 分钟增加 10k ,最高到 180k 行/秒。一个系统的最大写入速率,是指它在一个完整的 10 分钟阶梯内平均能成功存储的最高速率。如果系统发生崩溃,我们只统计它首次崩溃之前的阶梯,因为崩溃本身就是它的极限。
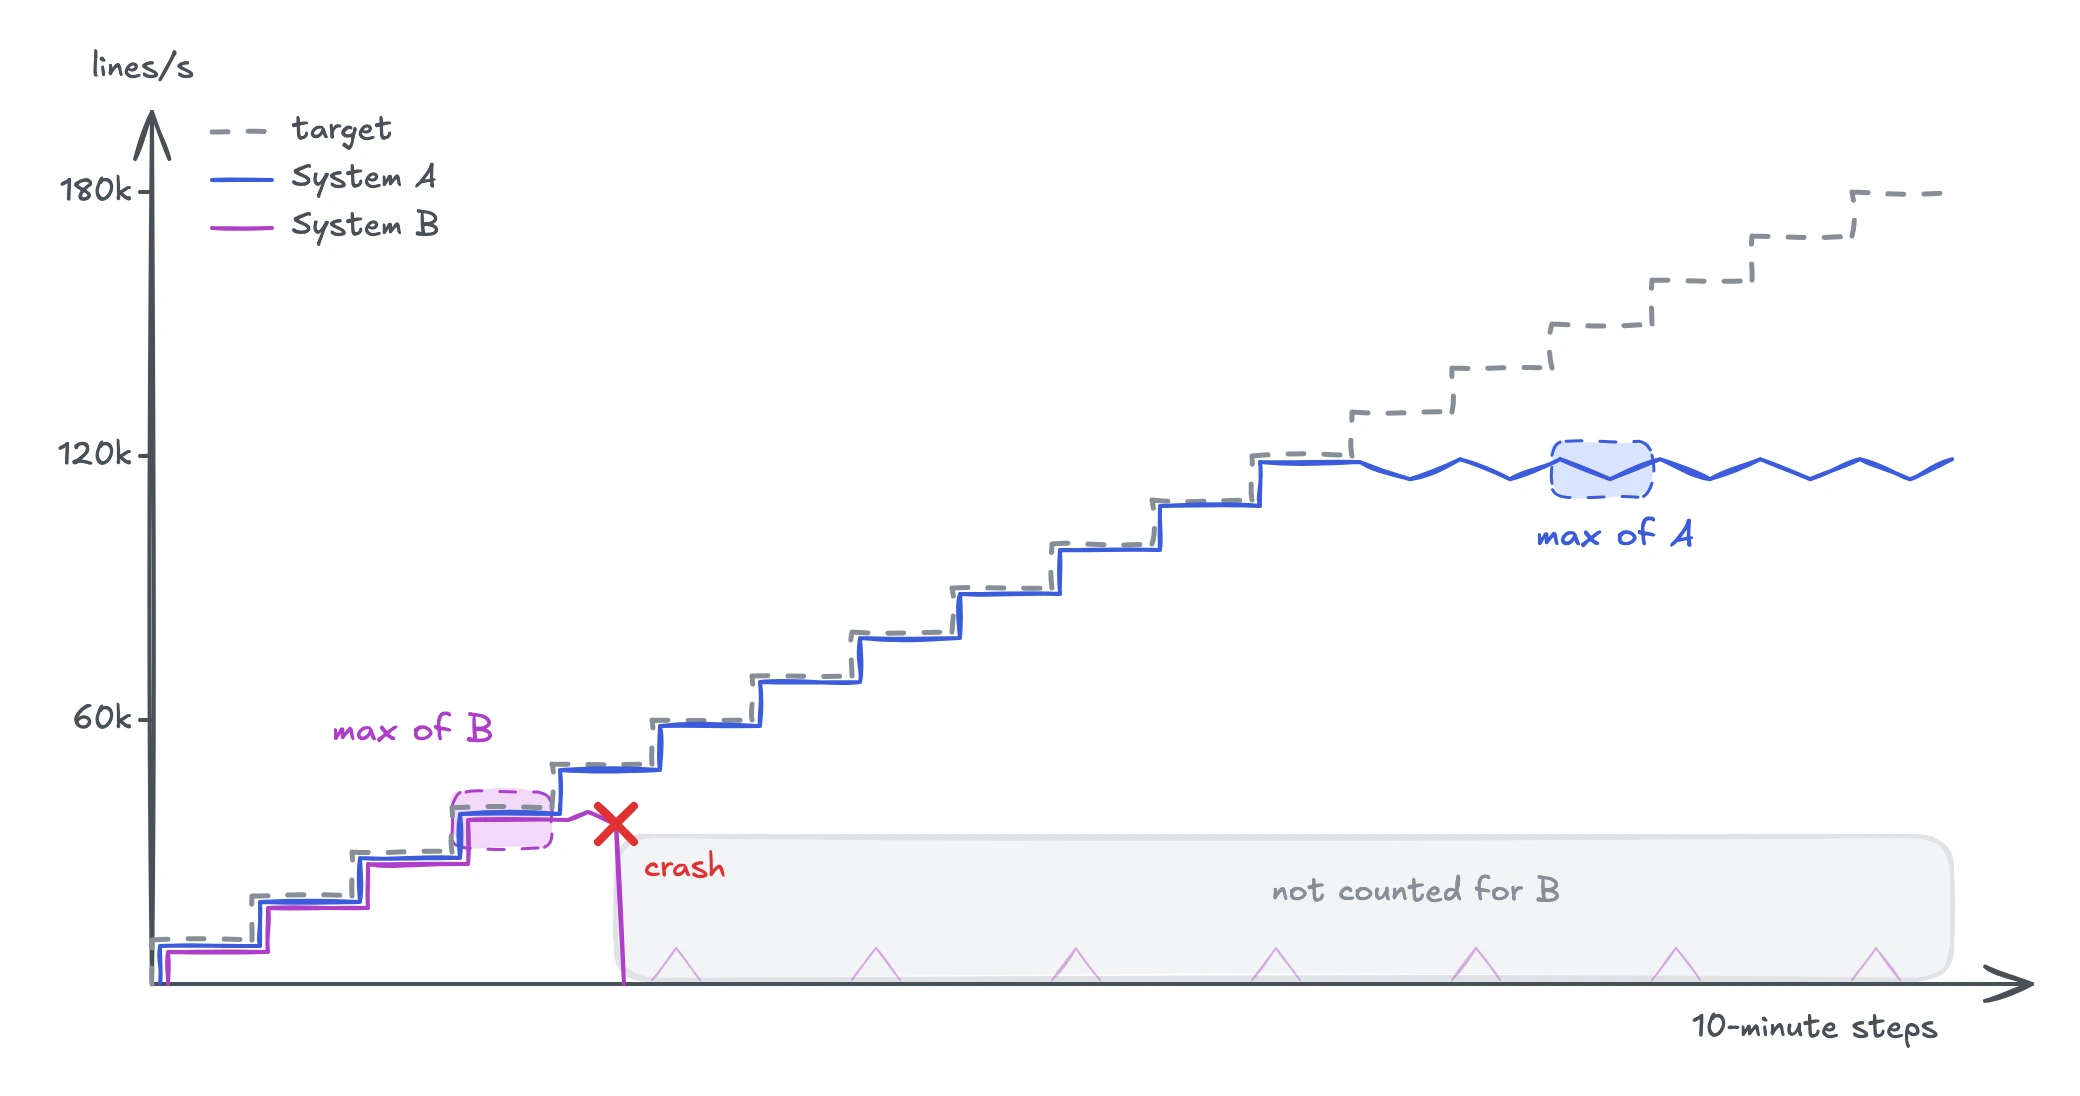
我们统计的是每个系统实际存储的行数,而不是它接收的行数。例如,SigNoz 和 ClickStack 在 Collector 收到日志后就会立即返回响应,因此 Collector 一旦崩溃,就会丢失已经被接收的日志。Loki 是个例外:它没有低成本的方法统计已存储的行数,但它会在返回响应之前把每一行写入 WAL ( Write-Ahead Log ,预写日志),所以对于 Loki ,我们统计的是接收的行数。
写入速率只是故事的一半。为了展示它与查询速度之间的关系,我们以 35k 行/秒的速率向 VictoriaLogs 、Elasticsearch 和 Loki 写入相同的日志,持续 4 小时,然后在冷缓存状态下对几条常见查询进行计时。我们会在后续文章中深入讨论查询。
每个系统接收的负载
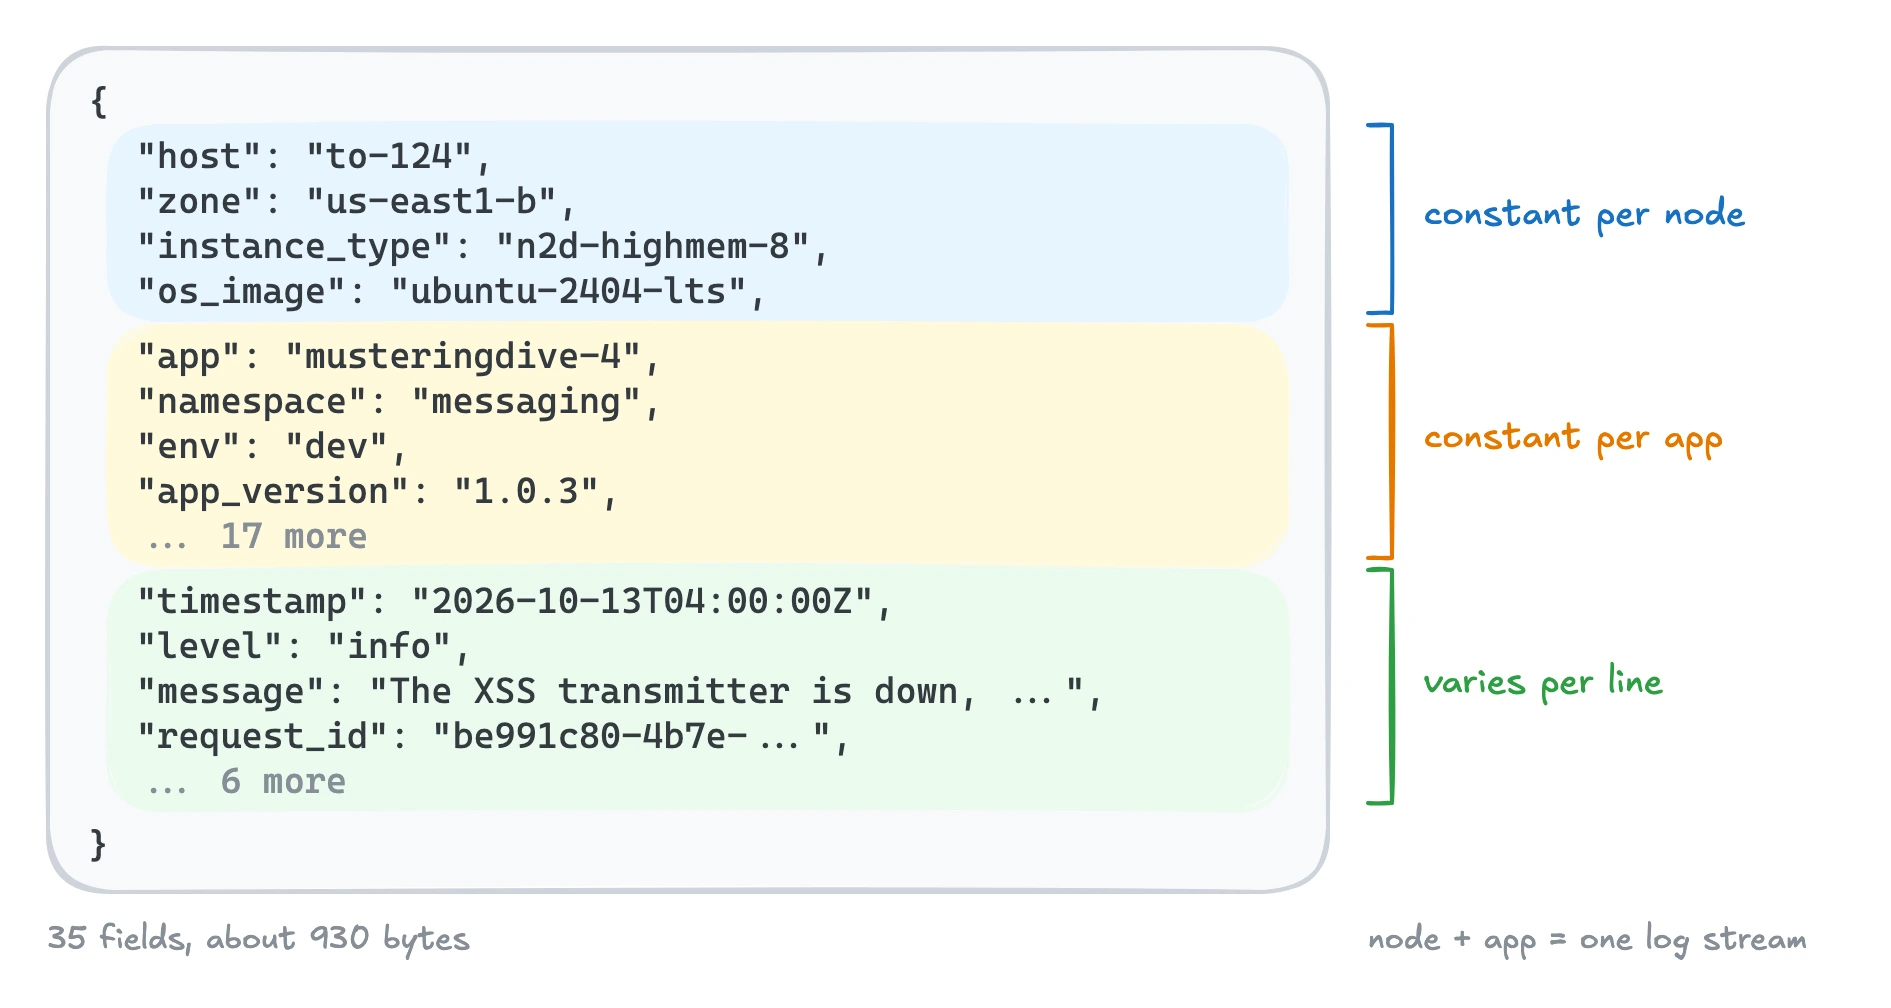
日志可以是任何东西,从纯文本到包含数百个字段的 Wide Events (宽事件)。本测试选取了中间情况:每行包含 30 到 40 个字段的结构化日志,这在 Kubernetes 中很典型。其中约 20 到 30 个字段由应用写入,日志采集器再额外添加约 10 个字段,例如命名空间、节点和标签。
设想一个有 125 个节点的 Kubernetes 集群,每个节点运行 40 个属于不同应用的 Pod 。每个 Pod 的日志构成一个日志流,因此这个集群共有 5,000 个日志流。这是一个中等规模的集群,与我们在 VictoriaLogs 用户中见到的许多集群类似。
我们想看看每个系统基于自身设计能走多远。因此,每个系统都以它偏好的格式接收日志。例如,Loki 通常从 Grafana Alloy 接收 protobuf 格式。我们没有向所有系统发送同一种格式(如 OTLP )。如果那样做,我们测量的就不仅是各系统存储日志的能力,还包括它们转换该格式的效率。
在实际场景中,日志通常以 JSON 形式输出到 stdout 。因此日志采集器需要对其进行转换,而这同样会消耗 CPU 。如果有足够多的读者感兴趣,我们也可以用一种通用格式(如 JSON 或 OTLP )重新运行测试。
测试结果
主写入测试我们运行了 3 次,下面的结果取 3 次运行的中位数。完整的数据表格见仓库。
对于 SigNoz 和 ClickStack ,CPU 和内存包含了 Collector 、ClickHouse 及其辅助服务。
本文中提到的少数额外测试(例如查询测试)是仓库之外的一次性运行。
最大写入速率(行/秒)
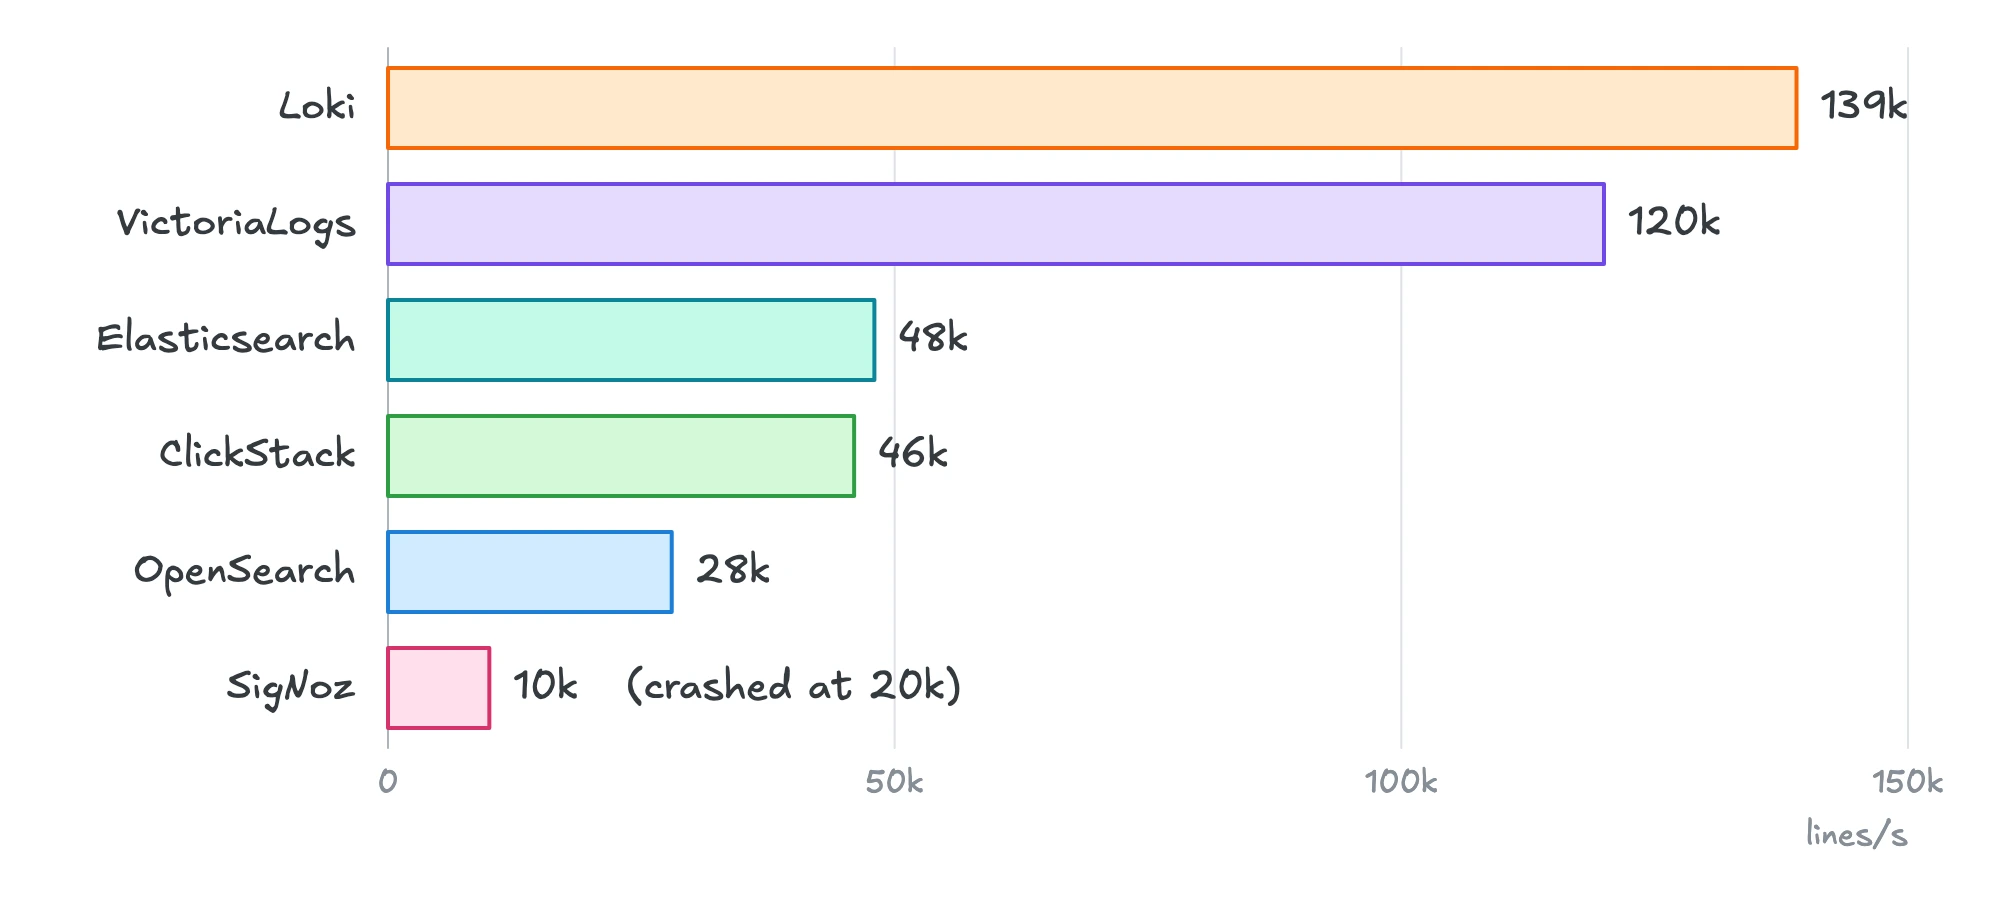
- Loki 写入最多,达到 139k 行/秒。
- VictoriaLogs 位居第二,为 120k 。
- Elasticsearch 、OpenSearch 和 ClickStack 在 28k 到 48k 之间。
- SigNoz 达到 10k 行/秒,并在 20k 时崩溃。
一行日志约为 930 字节的 JSON ,因此 120k 行/秒约等于 106 MiB/s ,即每天约 9 TiB 的原始日志。
每个数字的背后都伴随着在查询速度、成本或日志类型上的权衡。我们会在为什么会是这样的结果中进行解释。
CPU 使用量(核)
各写入速率下的平均 CPU 核数。每条曲线终止于该系统的最大写入速率。
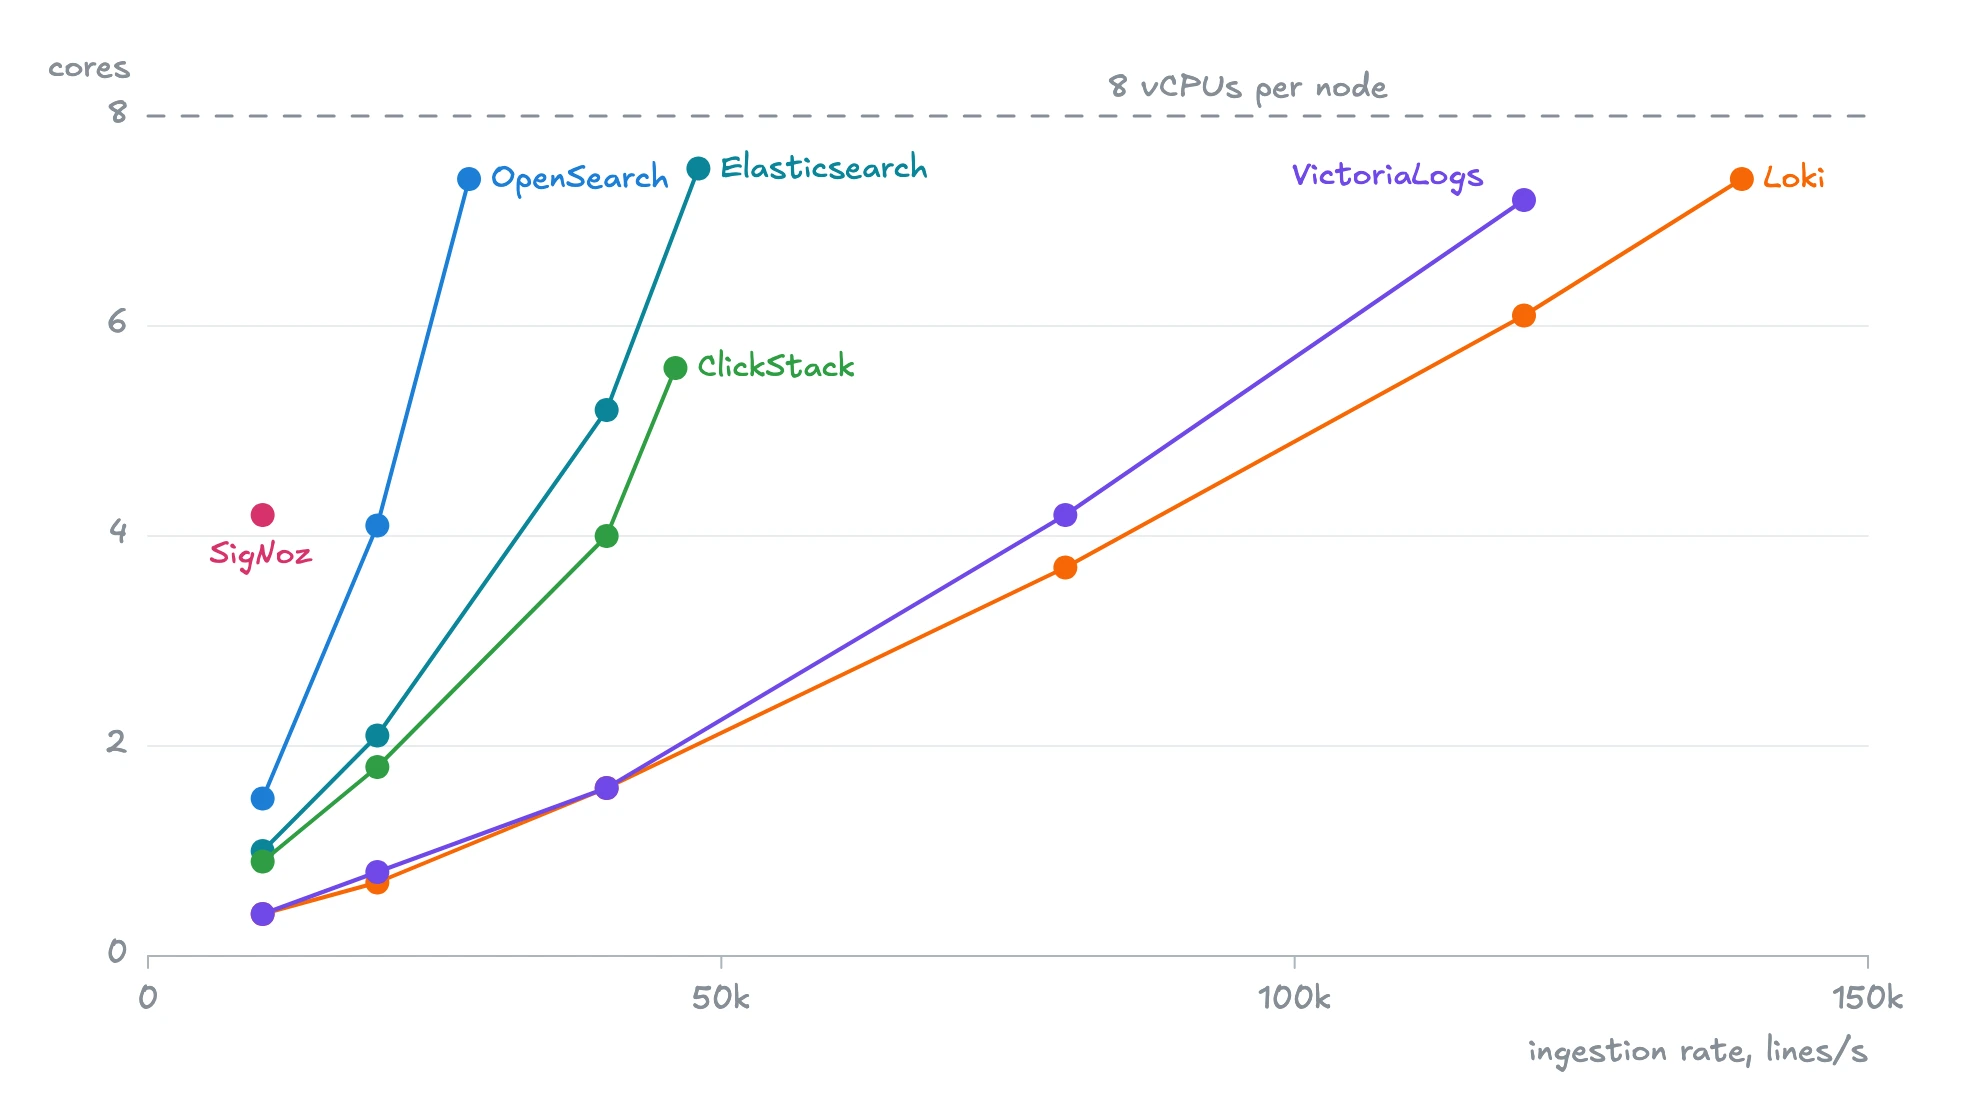
- 在 10k 行/秒(所有系统都能承受的唯一速率)下,VictoriaLogs 和 Loki 使用 0.4 核,ClickStack 0.9 核,Elasticsearch 1.0 核,OpenSearch 1.5 核,SigNoz 4.2 核。
- 差距随速率增长而扩大。在 40k 行/秒时,VictoriaLogs 和 Loki 使用 1.6 核,ClickStack 4.0 核,Elasticsearch 5.2 核。
- 在 120k 行/秒时,Loki 使用 6.1 核,VictoriaLogs 使用 7.2 核。
在本次测试中,CPU 是大多数系统的瓶颈。
内存使用量( GiB )
各写入速率下的峰值内存,不含操作系统的 Page Cache 。每条曲线终止于该系统能跟上的最后一个速率。
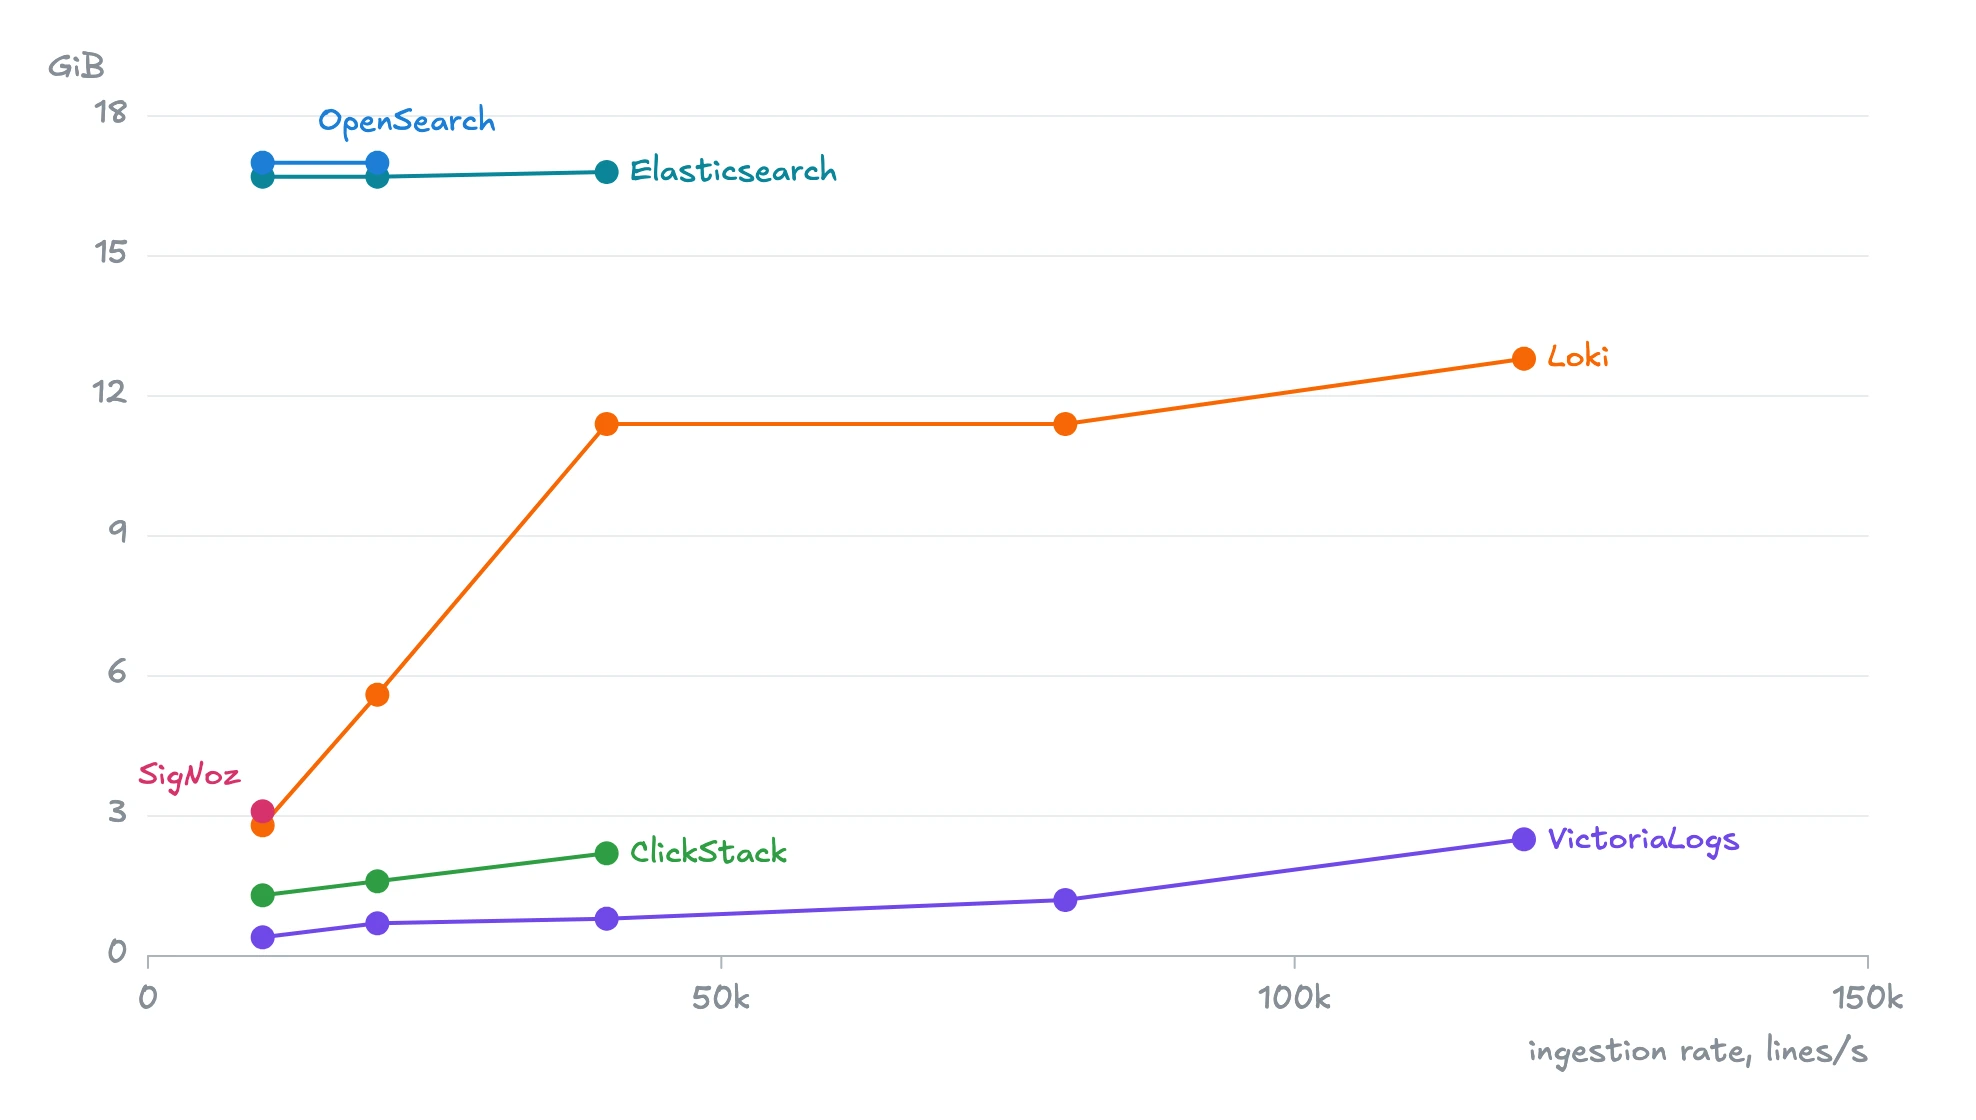
- VictoriaLogs 在所有速率下内存占用都最少,在 40k 行/秒时比 Loki 少 14 倍。
- Elasticsearch 和 OpenSearch 无论速率如何都使用约 17 GiB ,因为它们在启动时会预留固定大小的堆内存。默认情况下,Elasticsearch 会将堆大小设为机器内存的一半(源码)。OpenSearch 不会自动设置堆大小,所以我们给它配置了相同的大小。
- ClickStack 在 10k 行/秒时使用 1.3 GiB ,在 40k 行/秒时使用 2.2 GiB 。
- SigNoz 在 10k 行/秒时使用 3.1 GiB ,这是它在图表中唯一的数据点。
内存决定了机器需要多大、成本多高,以及还剩多少内存可用于缓存和查询。
磁盘空间
下图展示了每个系统存储一百万行日志所需的磁盘空间。作为参考,一百万行日志以原始 JSON 形式约占 887 MiB 。SigNoz 标为 N/A ,因为它的 Collector 反复崩溃,存储的行数太少,且多次运行之间的数据波动太大,无法进行比较。
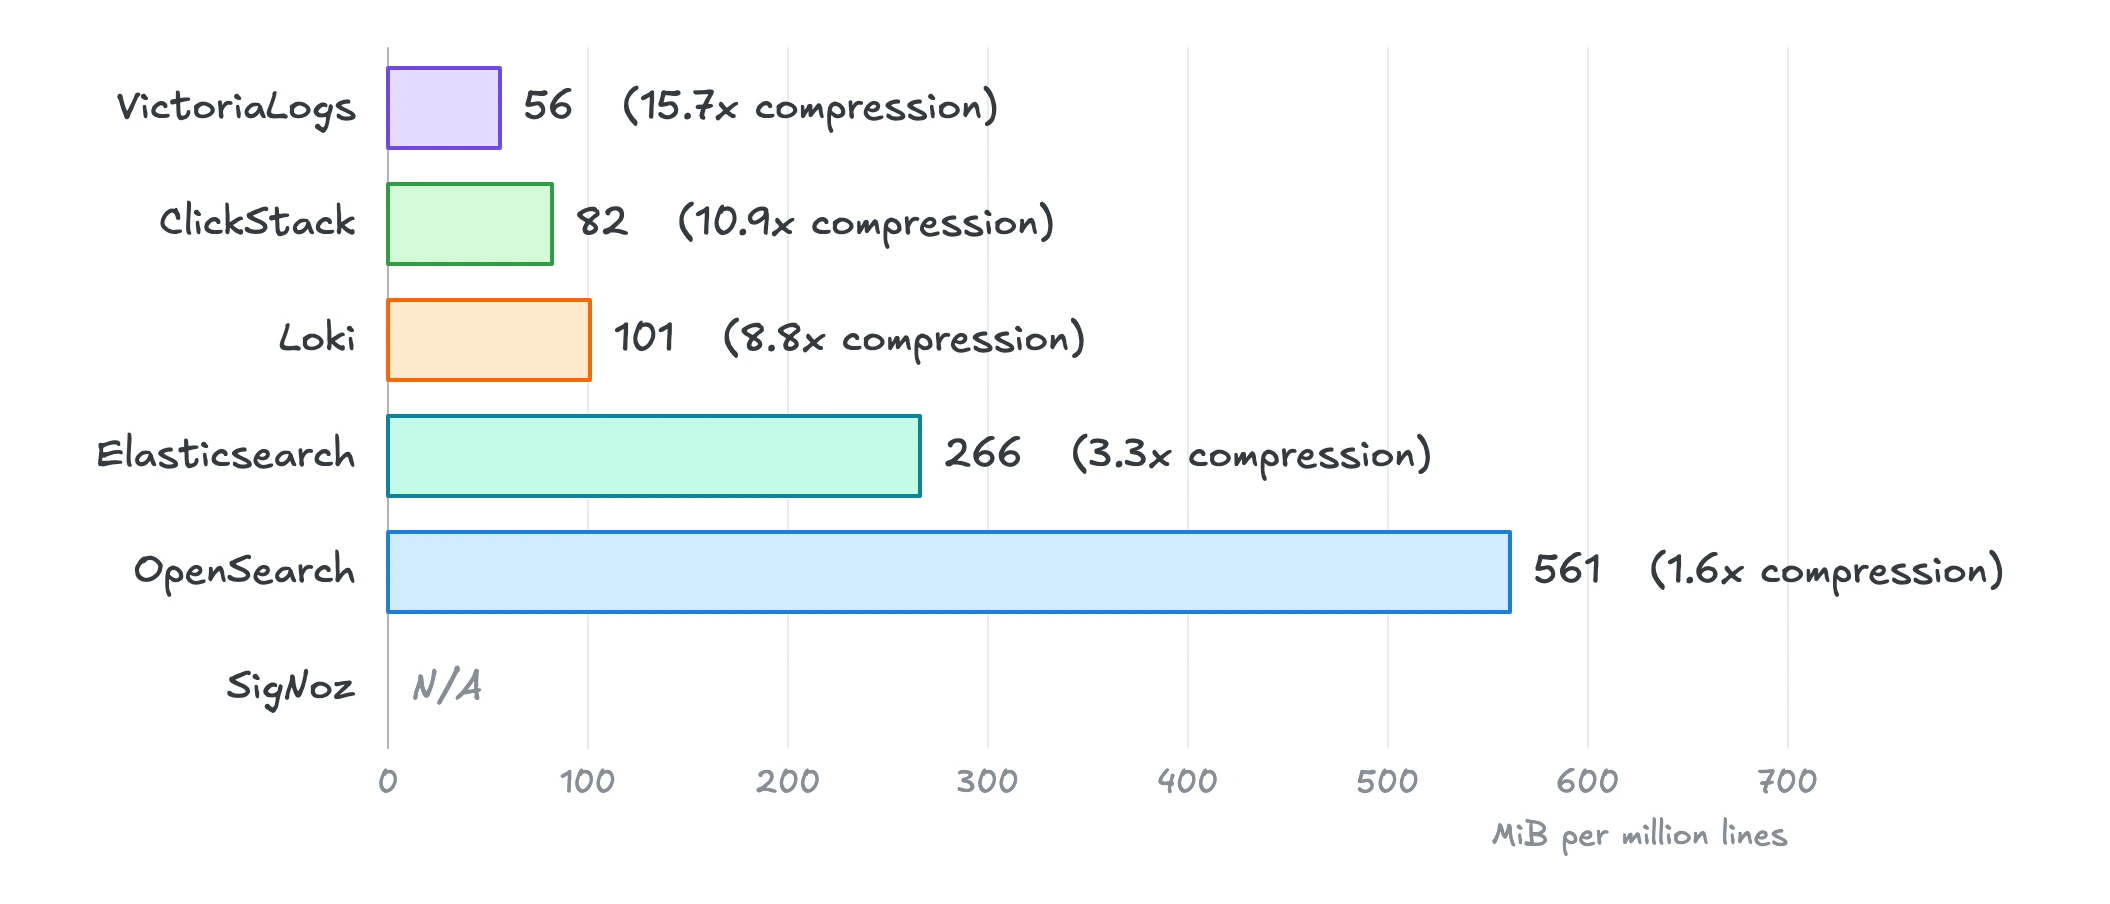
- VictoriaLogs 所需磁盘空间最少,其次是 ClickStack 和 Loki。
- Elasticsearch 所需空间几乎是 VictoriaLogs 的 5 倍,OpenSearch 则是 10 倍。
日志通常会保留数周,因此磁盘空间增长很快。例如,以 50k 行/秒的速率保存 30 天的日志,VictoriaLogs 约需 7 TiB ,Loki 约需 12 TiB ,Elasticsearch 约需 33 TiB 。
磁盘写入量
下表展示了每个系统每存储一行日志向磁盘写入的字节数。这个数值会大于最终的磁盘占用,因为每个系统都会不时重写数据,以保持数据紧凑并便于搜索。N/A 表示该系统无法跟上对应的速率。
| 系统 | 10k | 20k | 40k | 80k | 120k | 150k |
|---|---|---|---|---|---|---|
| Loki (protobuf) | 1,108 | 1,234 | 1,411 | 1,251 | 1,210 | N/A |
| VictoriaLogs | 323 | 284 | 226 | 223 | 163 | N/A |
| Elasticsearch | 1,393 | 1,815 | 1,917 | N/A | N/A | N/A |
| OpenSearch | 2,295 | 3,197 | N/A | N/A | N/A | N/A |
| SigNoz | 1,420 | N/A | N/A | N/A | N/A | N/A |
| ClickStack | 414 | 461 | 572 | N/A | N/A | N/A |
VictoriaLogs 每行写入磁盘的数据量同样最少,而且在更高速率下写得更少,因为一次写入更多行时压缩效果更好。Loki 每行的写入量是它的 3 到 7 倍,具体取决于速率。
这一点很重要,因为每块磁盘每秒能写入的字节数都有上限,而更快的磁盘也更贵。在我们的测试中,使用的是 GCP 上 500 GiB 的 pd-balanced 磁盘,最高写入速度为 280 MiB/s ,所以没有任何系统在耗尽 CPU 之前触及这个上限。尽管如此,VictoriaLogs 能让你使用更便宜的磁盘;在自有硬件上,它对 SSD 的磨损也要慢得多。
为什么会是这样的结果
Loki
Loki 的高写入速率让我们感到意外,但它的设计可以解释这一点。Loki 的设计目标是存储大量日志,之后只在较短的时间范围内读取少数几个日志流。因此它只为流标签(这里是节点和应用)建立索引,并原样存储每一行日志。相比之下,VictoriaLogs 会把每一行拆分为字段,并分别存储每个字段,从而让后续的查询更快。在 120k 行/秒时,这会比 Loki 多消耗约 18% 的 CPU 。
向 Loki 发送日志的方式也很重要。Grafana Alloy 和 Vector 默认发送 protobuf ,而 Fluent Bit 、Fluentd 和 Logstash 发送 JSON 。在另一次单独的测试中,使用 JSON 时 Loki 只达到约 99k 行/秒,低于 VictoriaLogs ,因为处理 JSON 比处理 protobuf 消耗的 CPU 多得多。所以如果你使用 Loki ,建议优先选择 Alloy 或 Vector 。
Loki 的设计有 3 个代价。第一个代价是内存。Loki 会把每个流最新的日志行保存在内存中,以便将它们一起压缩。这意味着它的内存会随着流的数量增长。集群越大,流就越多;任何集群在部署期间流也会增多,因为每个新 Pod 都会产生一个新的流。为了观察这会占用多少内存,我们还分别用 10,000 和 15,000 个流运行了测试。
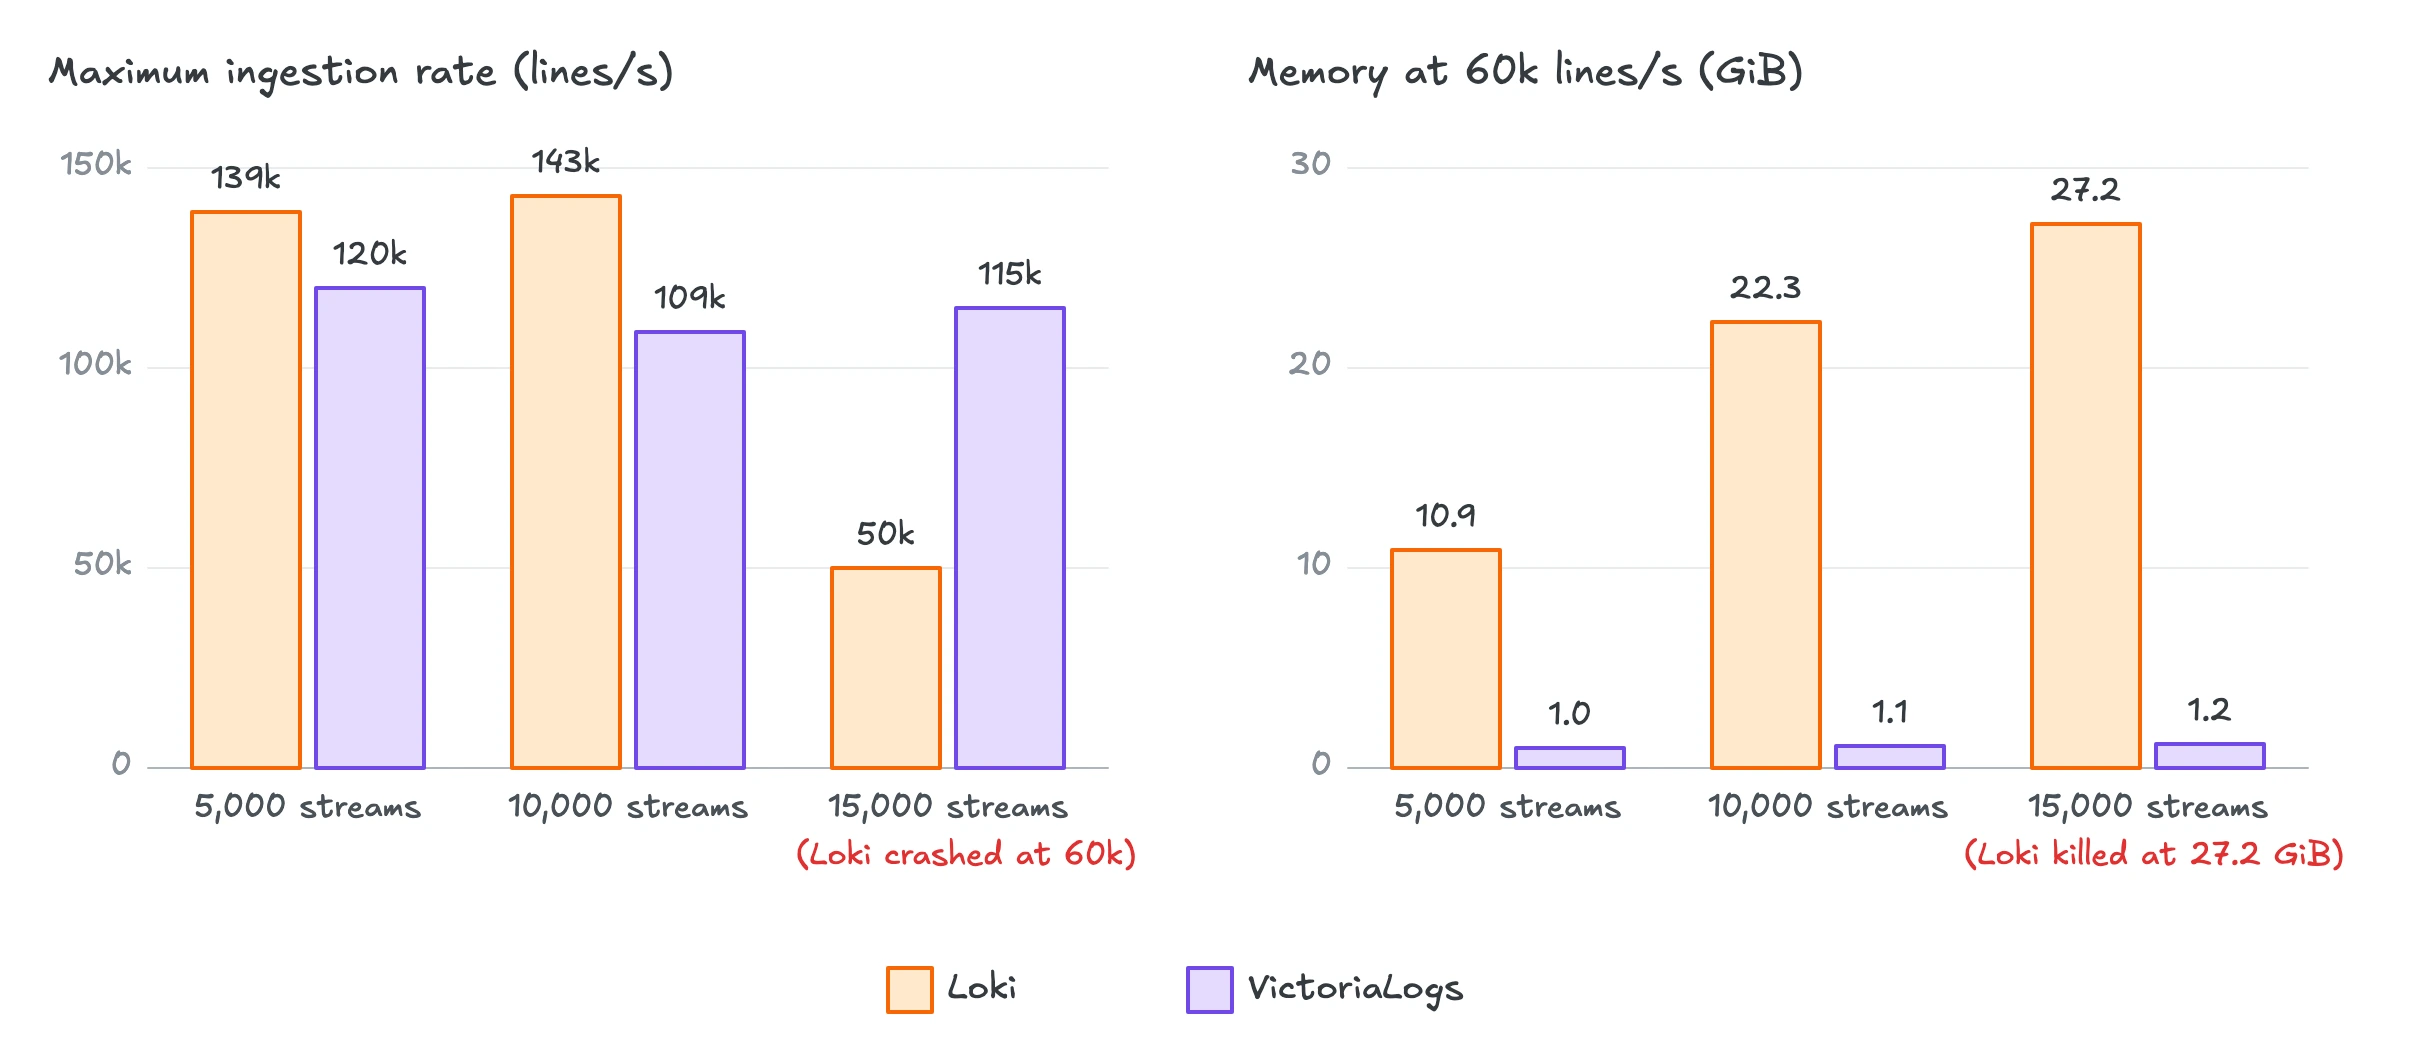
在 15,000 个流时,Loki 在 60k 行/秒时因 OOM 被杀死。而 VictoriaLogs 在流数量增加到 3 倍的情况下,仅多用了 0.2 GiB 内存。更多的内存意味着更大的机器,也意味着可用于缓存查询数据的内存更少。
第二个代价是磁盘。Loki 把日志行当作纯文本进行压缩。它不像 VictoriaLogs 和 ClickHouse 那样利用行内的字段来获得更好的压缩效果,因此它所需的磁盘空间是 VictoriaLogs 的 1.8 倍。
第三个也是最重要的代价是查询时间。Loki 只能通过标签来缩小查询范围。除此之外的任何条件,比如一个单词或一个字段值,都需要对匹配流中的每一行进行解压和扫描。在相同的日志上,前文提到的查询耗时如下。
| 查询问题 | 时间范围 | VictoriaLogs (秒) | Loki (秒) |
|---|---|---|---|
| 统计某个应用的错误数 | 1 小时 | 0.06 | 3.5 |
| 统计每个应用的错误数 | 1 小时 | 0.59 | 171 |
| 包含某个常见词的最新 100 行 | 1 小时 | 2.5 | 32 |
| 每个应用的 p99 延迟 | 1 小时 | 1.9 | 302 |
| 前 10 个请求路径 | 1 小时 | 8.8 | 被拒绝,超过 500 个 Series |
这些都是排查故障、构建 Dashboard 和告警时的日常问题。除第一条外,Loki 在所有查询上都要花费半分钟甚至更久,或者直接拒绝执行。第一条查询只通过标签读取一个应用的数据,即便如此,它也比 VictoriaLogs 慢了近 60 倍。
Loki 正在增加更快搜索字段的方法,例如 Bloom Filter (布隆过滤器),但这些功能仍处于实验阶段,默认关闭,并且在单节点上不可用,所以我们没有启用它们。
这些缓慢的查询并不意味着 Loki 总体上是一个糟糕的日志方案。它的设计目标是把日志低成本地保存在对象存储中,并在需要执行大型查询时横向扩展到许多查询工作节点上。在我们的单台机器上,统计一小时内每个应用的错误数花了 171 秒,大约使用了 8 核中的一半。粗略估算,若要在约 2 秒内得到结果,同样的扫描大约需要 300 个核。所以,如果你想把大量日志低成本地存储在对象存储中,并且要么只读取其中一小部分,要么愿意为大量 CPU 核付费以实现快速搜索,那么 Loki 适合你。
如果这超出了你愿意承担的成本,而你仍然需要 Dashboard 和搜索在几秒内返回结果,请继续往下读。
Elasticsearch 和 OpenSearch
OpenSearch 是 Elasticsearch 的一个 Fork ,所以本节主要介绍 Elasticsearch ,最后再说明 OpenSearch 的不同之处。
Loki 几乎不建索引,并在查询时为此付出代价。Elasticsearch 则恰恰相反。它以 3 种形式存储每一行日志:
- 该行的原始 JSON。
- 倒排索引,一个将每个单词和值映射到包含它们的日志行的字典,因此搜索可以直接定位到匹配的行。
- 再以列的形式存储一遍字段( doc values ),用于排序和聚合。
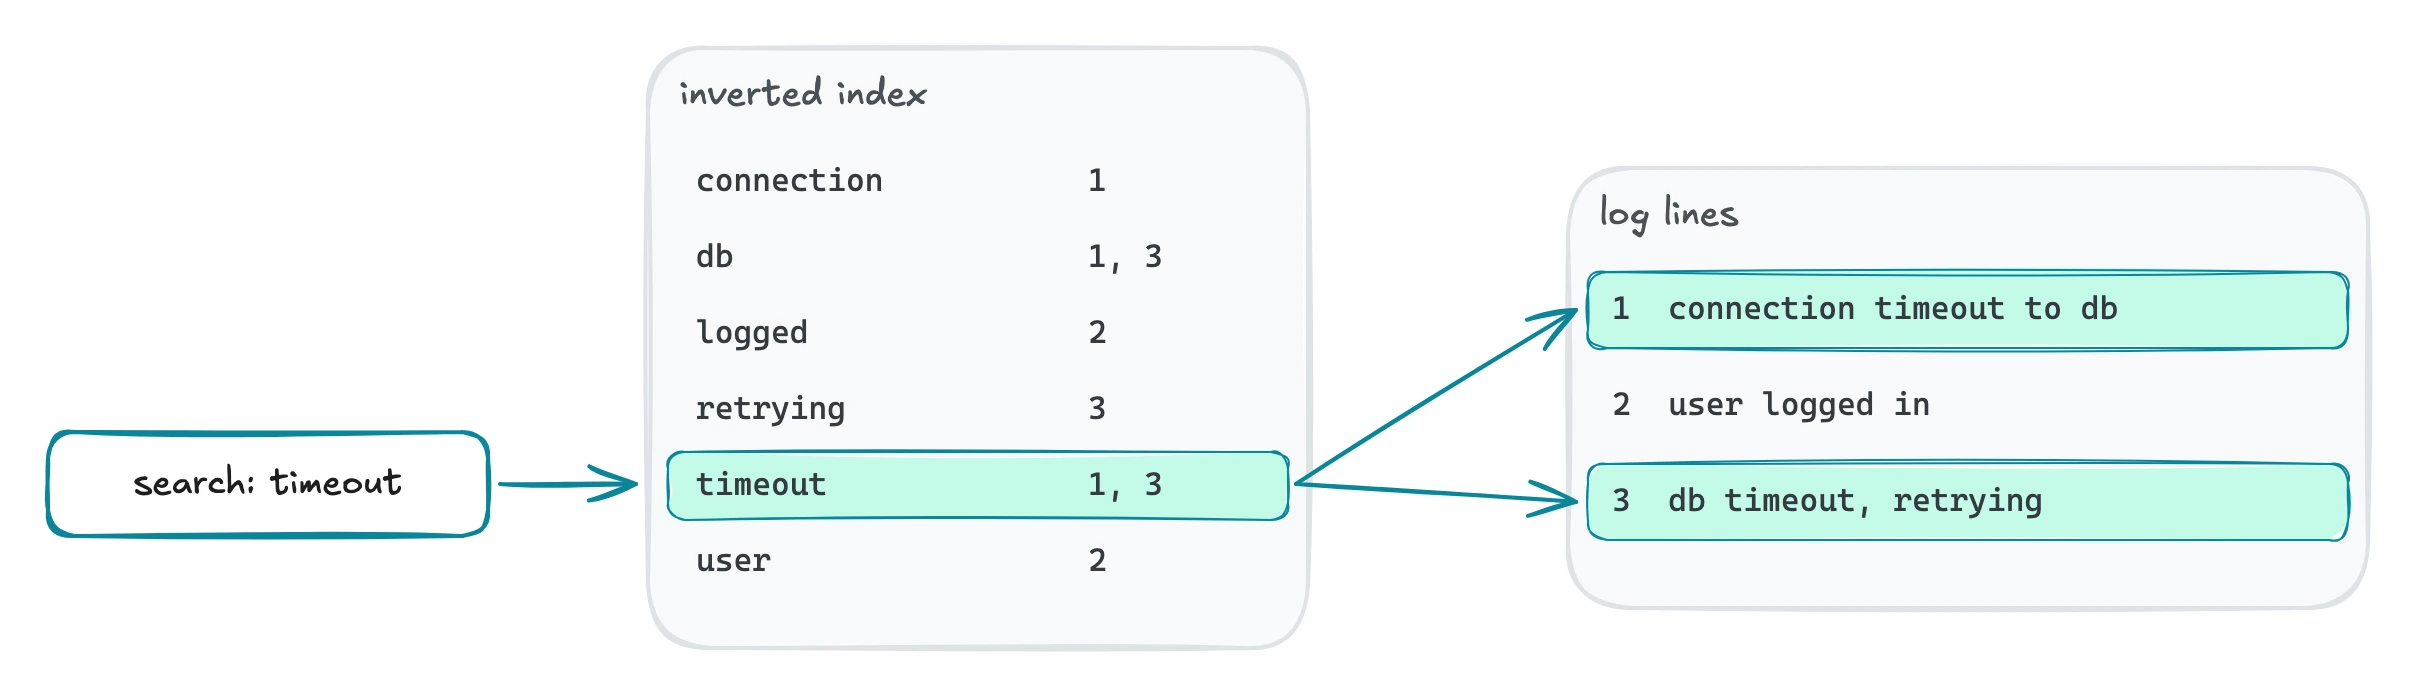
这一切都让写入变得昂贵。在 40k 行/秒时,Elasticsearch 使用了 5.2 核,而 VictoriaLogs 和 Loki 只用了 1.6 核;它在约 48k 行/秒时耗尽了 CPU 。瓶颈在于 CPU ,而不是磁盘。Elasticsearch 会在返回响应前把每个请求写入磁盘,但我们在另一次单独测试中关闭了这一行为,写入速率几乎没有变化。
我们的测试使用了 LogsDB,这是 Elasticsearch 针对日志推出的更新、更紧凑的索引模式。但即便如此,Elasticsearch 使用的磁盘空间仍是 Loki 的 2.6 倍,几乎是 VictoriaLogs 的 5 倍。
作为回报,Elasticsearch 查找数据的速度比 Loki 快得多。在 Loki 需要几分钟的查询上,Elasticsearch 只需几秒甚至更短。下面是它与 VictoriaLogs 在几类常见查询上的对比。
| 查询问题 | 时间范围 | VictoriaLogs (秒) | Elasticsearch (秒) |
|---|---|---|---|
| 统计包含某个常见词的行数 | 1 小时 | 6.5 | 0.10 |
| 统计每个应用的错误数 | 1 小时 | 0.59 | 0.46 |
| 每个应用的 p99 延迟 | 1 小时 | 1.9 | 3.9 |
| 前 10 个请求路径 | 1 小时 | 8.8 | 14.7 |
| 统计包含某个双词短语的行数 | 1 小时 | 4.4 | 175 |
Elasticsearch 查找单个词或值几乎是瞬间完成的,在简单计数(例如统计每个应用的错误数)上也更快。而一个短语,比如 "connection timeout",则花了它大约 3 分钟。
为了节省磁盘,它针对日志的默认配置不会存储每个单词在行中的位置,因此它必须重新读取日志行,才能判断两个词是否相邻。VictoriaLogs 在这类查询上更快,在百分位数和 Top 值查询上也更快。
Elasticsearch 之所以流行,是因为它能快速搜索任意字段。人们对它的抱怨通常集中在两点:
- 成本。 为每个字段建立索引会消耗大量 CPU 、内存和磁盘。
- 运维。 运维大型集群需要投入大量精力。
Uber 同时遇到了这两个问题。索引成本高昂,而且 Uber 在每个区域运行了 20 多个集群,以确保一个集群故障不会影响全局(Uber)。Cloudflare 则不得不对部分日志进行采样,因为全部存储需要数百 TB 的空间(Cloudflare)。两家公司都把部分最大规模的日志负载迁移到了 ClickHouse 。
OpenSearch 的写入量略高于 Elasticsearch 的一半( 28k 对 48k 行/秒),磁盘占用约为后者的两倍。它与 Elasticsearch 在两项默认设置上有所不同:
- 它没有类似 LogsDB 的模式,因此对每行原始 JSON 的压缩没那么紧凑(OpenSearch 文档),也不会预先排序。
- 它没有内置的日志模板,因此大多数字符串字段会被索引两次:一次按分词,一次按精确值。
OpenSearch 与 Elasticsearch 共享相同的内核,因此通过更强的压缩、排序以及完整的日志模板,你很可能可以弥补大部分差距。我们刻意让它保持接近默认配置,以展示开箱即用时的表现。
Loki 以牺牲查询速度为代价换取快速写入。Elasticsearch 以牺牲写入速度和存储为代价换取快速搜索。那么 VictoriaLogs 又提供了什么呢?
VictoriaLogs
如今,许多公司都在输出结构化日志,每一行都带有命名字段,例如日志级别、HTTP 状态码或请求耗时。VictoriaLogs 利用了这类日志的两个特性,使写入和查询都能保持高速。
- 同一个流中的日志看起来很相似。它们的字段几乎相同,而且许多字段几乎不变。每一行的命名空间都相同,日志级别也只有少数几个取值。VictoriaLogs 会把每个流的日志存放在一起,并把每个字段存储在独立的列中,这比存储整行日志的压缩效果好得多。
- 许多查询只需要少数几个字段。例如,统计每个应用的错误数只需要应用和级别两个字段。VictoriaLogs 只读取查询所需的列。
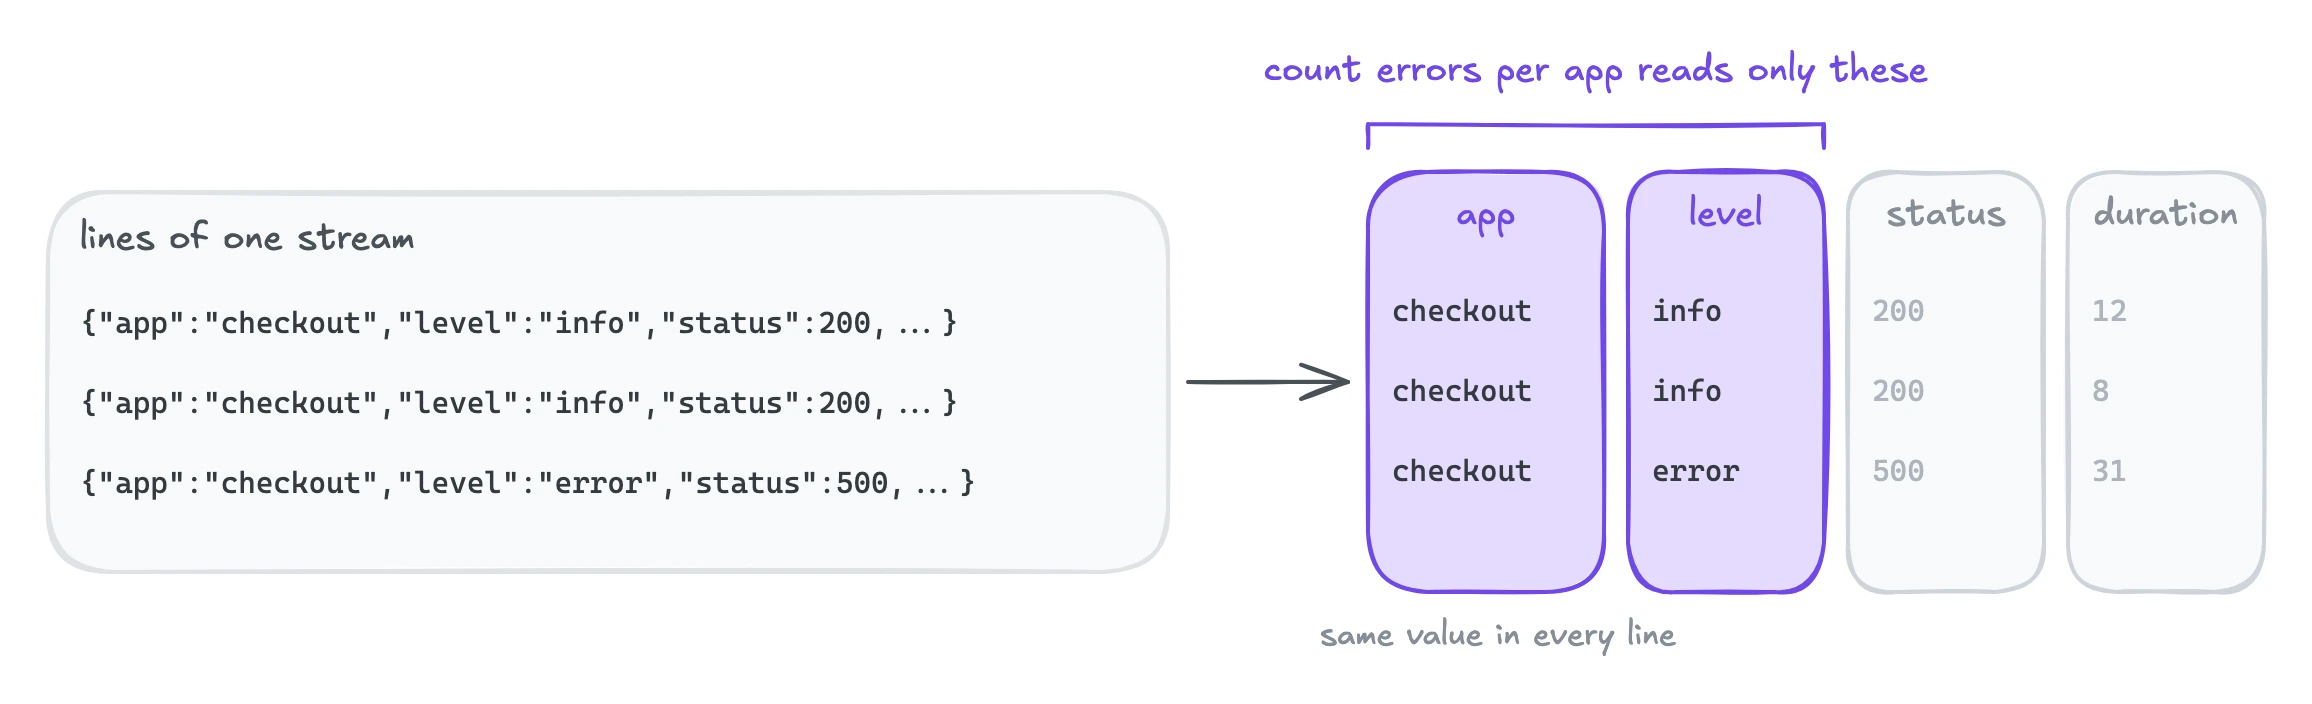
这种存储方式本身就让 VictoriaLogs 在磁盘上非常紧凑,聚合也很快,所以它在写入时只需构建轻量的索引和少量元数据。这就是为什么它能以 120k 行/秒的速率写入,是 Elasticsearch 的 2.5 倍,同时磁盘占用少 4.7 倍。正如前文所述,只有 Loki 的写入速度更快。更多细节请参阅 VictoriaLogs 如何存储你的日志。
在查询方面,VictoriaLogs 在几秒内响应了所有查询,并且在每一条查询上都比 Loki 快。与 Elasticsearch 相比则互有胜负,我们会在关于查询的文章中详细分析。为了保持低成本的写入和存储,VictoriaLogs 不会构建完整的倒排索引。其代价是,搜索一个常见词(出现在大量行中的词)会比较慢。而查找一个罕见词(例如用户 ID )依然很快,因为 Bloom Filter 可以让它跳过不可能包含该词的数据。
VictoriaLogs 使用的内存也少得多。在 40k 行/秒时,Loki 使用的内存约为它的 14 倍( 11.4 GiB 对 0.8 GiB );在 120k 行/秒时约为 5 倍( 12.8 GiB 对 2.5 GiB )。这些空闲内存并不会被浪费。操作系统会用它来缓存最近写入或读取的数据,因此许多查询(尤其是针对近期日志的查询)可以直接从内存而不是磁盘读取数据。它也为大量并发查询留出了空间,我们计划在后续关于查询的文章中对此进行测试。
公平地说,本次基准测试使用的是结构化日志,这正是 VictoriaLogs 的优势所在。而针对这类日志的日常工作,很大一部分也是用于 Dashboard 、告警和分析的聚合,这正是列式存储最能发挥作用的地方。如果你的日志是非结构化的,例如老旧应用和网络设备输出的纯文本日志,VictoriaLogs 依然能很好地写入和搜索它们,但收益会比结构化日志小一些。
SigNoz 和 ClickStack
SigNoz 和 ClickStack 比 Loki 更让我们意外。两者都把日志存储在 ClickHouse 中,而 ClickHouse 和 VictoriaLogs 一样是列式数据库,所以我们原本预期它们的表现会接近 VictoriaLogs 。但事实并非如此。ClickStack 达到 46k 行/秒,SigNoz 只有 10k ,而 VictoriaLogs 为 120k 。在磁盘空间方面,ClickStack 排名第二,但每百万行仍需要 82 MiB ,是 VictoriaLogs 的 1.5 倍。
较低的写入速率来自两个搭建在 ClickHouse 之上的方案,来自于它们的 Collector 。ClickHouse 是一个通用数据库,无法直接接收常见格式的日志,因此需要由一个 OpenTelemetry Collector 先把日志转换成行数据。这个 Collector 消耗的 CPU 比 ClickHouse 本身还多。在 SigNoz 中,10k 行/秒时 Collector 使用了 2.7 核,而 ClickHouse 为 1.5 核;在 ClickStack 中,达到最大速率时两者分别为 3.3 核和 2.2 核。
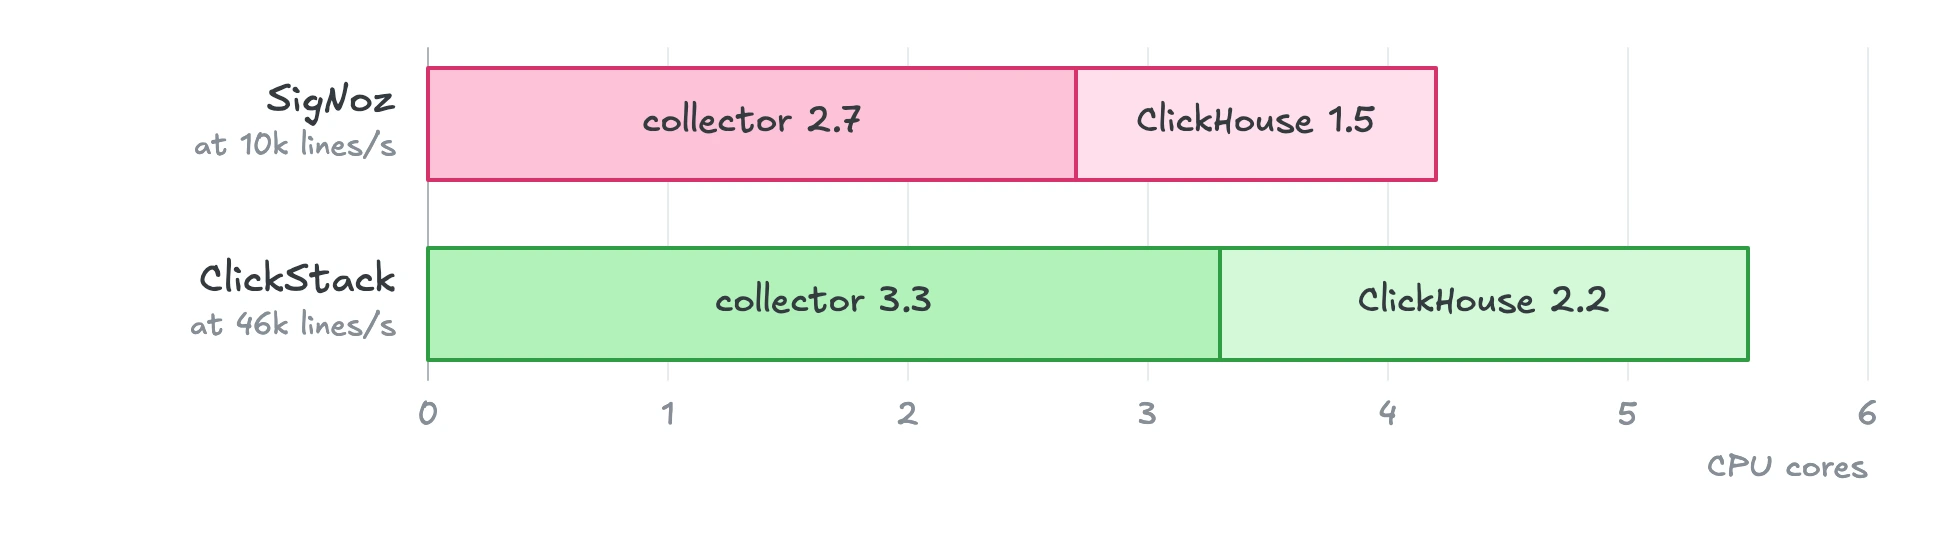
更大的磁盘占用可能源于两个技术栈存储字段的方式。它们把日志存储在一张固定列的 ClickHouse 表中,但 OpenTelemetry 日志格式 只有少数几个固定字段,外加可以容纳任意自定义数据的 Attributes 。固定字段(如 Timestamp 、SeverityText 和 TraceId )拥有独立的列,压缩效果很好。而 Attributes 则被放入少数几个 Map 列中,许多字段的值混杂在一起,因此压缩效果较差,查询也更慢。
VictoriaLogs 受到了 ClickHouse 的启发,但它是专门为日志而构建的(FAQ)。它与 ClickHouse 有两点不同,这很可能解释了写入速率和磁盘空间上的大部分差距:
- 无需 Collector 。 VictoriaLogs 可以直接接收日志采集器已经在发送的各种格式,例如 OpenTelemetry 、Loki 、Elasticsearch 、Datadog 和 Splunk 。
- 无需 Schema 。 日志行中的每个字段都有自己独立的列,而不仅仅是少数几个固定字段。
在本次测试中,基于相同设计的 SigNoz 使用的 CPU 几乎是 ClickStack 的 5 倍,主要消耗在其 Collector 上。Collector 把这些 CPU 花在了额外的元数据上,这些元数据可以加速查询并为其 UI 提供支持,我们会在关于查询的文章中探讨这一权衡。此外,它默认不设内存上限,而我们保留了这一默认配置。因此当它处理不过来时,会把日志行一直堆积在内存中,直到被 Kubernetes OOM Kill 。其他用户也报告过类似的 Collector 崩溃问题(GitHub issue)。
公平地说,SigNoz 和 ClickStack 是完整的可观测性技术栈,它们把日志、指标和链路追踪汇集在一处,并把每条链路关联到对应的日志。本次测试只衡量了其中的一部分:日志写入。两个技术栈也都建议随着数据量增长增加更多的 Collector 。ClickHouse 的文档按约 3 核处理 60k 事件/秒来规划单个 Collector (ClickHouse 文档),而 SigNoz 自己的基准测试在一台 16 核机器上,于 ClickHouse 旁运行了 3 个 Collector ,达到约 55k 行/秒(SigNoz)。在我们的测试中,为了对所有系统公平,每个系统都只分配了一台 8 核机器,所以 Collector 不得不与 ClickHouse 共享资源。集群测试中各个组件可以独立扩展,能够展示它们从更大规模的部署中能获得多少收益,这也在我们的计划之中。
关键结论
每个系统都根据自身的优先级和架构做出了不同的权衡。
- Loki 写入最多,因为它建立的索引最少。代价是查询缓慢,除非你为更多 CPU 核付费来加速查询。
- Elasticsearch 和 OpenSearch 为每一行的每一个词建立索引。这让它们能够非常快速地查找单词和精确值。但代价是写入时 CPU 消耗高,并且需要大量存储空间。
- SigNoz 和 ClickStack 把日志存储在 ClickHouse 中。ClickHouse 并非专为日志而构建,因此两个技术栈都需要额外的组件,这会拖慢写入速度并增加成本。如果你希望把 OTLP 日志、指标和链路追踪集中在一处,它们会比较适合你。
- VictoriaLogs 受到 ClickHouse 的启发,但它是直接为日志而构建的。它充分利用现代结构化日志的特点,实现快速写入、秒级查询响应,并且在内存和磁盘上的成本最低。如果你的日志是纯文本,收益会小一些。
本文在单台机器、普通云盘上测试了结构化日志。在后续文章中,我们计划深入介绍查询、集群模式,以及在 VictoriaLogs 支持对象存储后的对象存储测试。
你可以使用我们的基准测试仓库复现主要的写入测试结果,也可以通过快速入门指南试用 VictoriaLogs 。如果你发现我们的测试环境有错误,或者知道如何更好地调优某个系统,欢迎在仓库中提交 issue ,或在 VictoriaMetrics 的 Slack 上联系我们。


 1
 Select Language